C言語の構造体で挫折する真相|ポインタ連携とメモリ配置の完全攻略
プログラミング学習において、ポインタと並ぶ「二大難所」として数々の学習者を阻んできたのがC言語の構造体です。基本文法を覚えた直後は「複数の変数をひとまとめにする便利な道具」と理解していても、実践的なコードに触れた瞬間、ポインタとの複合技、アロー演算子の混濁、そして不可解なメモリサイズの違いに直面し、頭を抱えるケースが後を絶ちません。
IoTデバイスの普及やエッジAIの進化が進む2026年現在においても、ハードウェアの性能を極限まで引き出す組み込み開発やOSカーネル、ゲームエンジンの低レイヤでは、C言語の構造体が根幹を担い続けています。なぜ構造体でつまずいてしまうのか、その根本原因は「文法の暗記」に終始し、「メモリ上で何が起きているか」という物理的な描像を捉えきれていない点にあります。本稿では、基礎構文から現場エンジニアを悩ませるメモリ配置の裏側まで、技術ジャーナリズムの視点から徹底解剖します。
📌 【この記事の重要ポイントまとめ】
- 要点1:構造体で挫折する最大の理由は、構文の問題ではなく「メモリ配置(アライメント・パディング)」と「ポインタ連携」の視覚的理解不足にある。
- 要点2:sizeof演算子で計算が合わない現象はCPUアクセスの最適化が原因であり、メンバの記述順ひとつでメモリ消費効率が劇的に変化する。
- 要点3:値渡しとポインタ渡しのオーバーヘッド差を意識し、typedefの乱用を避けてメモリの主権を把握することが一流のCエンジニアへの分水嶺となる。
なぜC言語の構造体で挫折する人が後を絶たないのか?基礎と定義の本質
プログラミング初学者が構造体に触れる際、教科書的な解説では「異なるデータ型を1つにまとめたもの」と教えられます。しかし、現場の第一線でコードを保守するソフトウェアエンジニアたちに取材すると、口を揃えて「その抽象的な説明こそが挫折の入り口だ」と指摘します。
構造体の本質は、単なるデータのコンテナではなく、「連続したメモリ空間の割り当てルールをプログラマ自身が定義する行為」にほかなりません。まずは基本となる定義とアクセスのメカニズムを整理します。
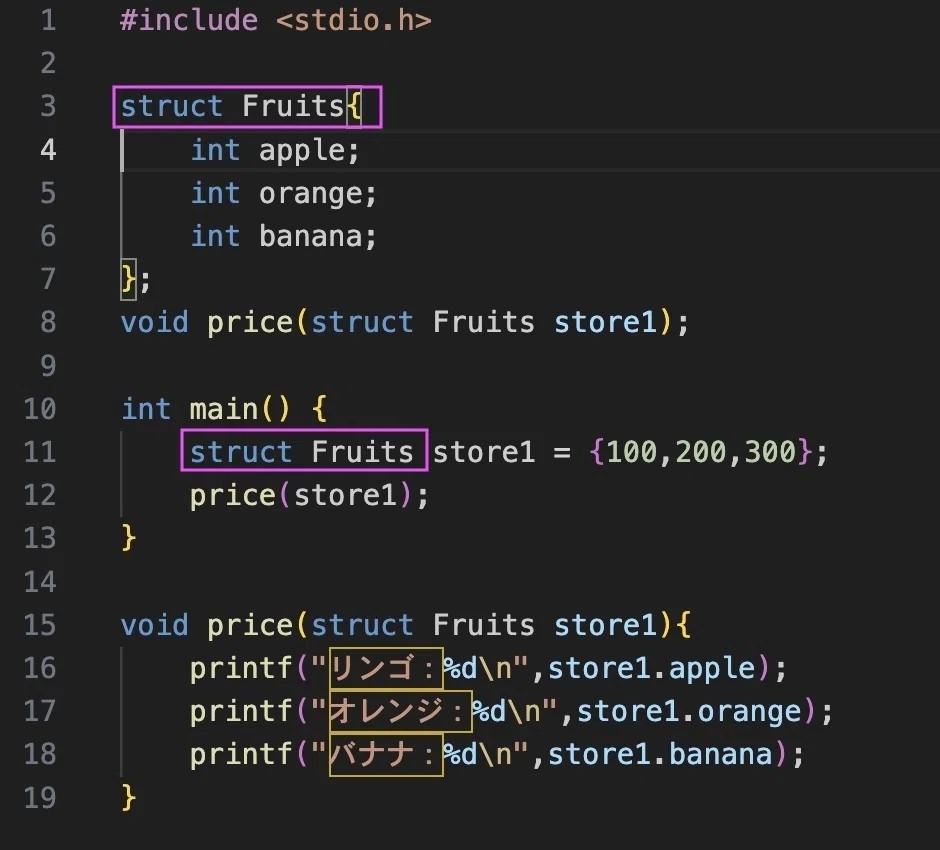
/* 基本的な構造体の定義 / struct SensorData { int id; / センサID (4バイト) / double value; / 計測値 (8バイト) / char status; / 状態フラグ (1バイト) / }; 構造体を宣言した段階ではメモリは確保されません。実体(インスタンス)を変数として宣言して初めて、メモリ領域が確保されます。実体のメンバへアクセスする際に使用するのがドット演算子(.)です。
/ 構造体の実体化とドット演算子によるメンバ参照 / struct SensorData s1; s1.id = 101; s1.value = 24.5; s1.status = 'A'; / C99規格以降で定着した「指示付き初期化」による安全な初期化 / struct SensorData s2 = { .id = 102, .value = 98.6, .status = 'O' }; 多くの初学者が混乱するのは、この「変数としてメモリを確保している実体」と、後述する「アドレスを指し示しているだけのポインタ」の境界線が曖昧になる瞬間です。変数の実体がどこに存在し、ドット演算子が「そのメモリブロックの先頭から何バイト目を直接指しているか」を意識することが、挫折を防ぐ第一歩となります。
【現場の混乱】typedefとアロー演算子を巡る落とし穴とベストプラクティス
コードの可読性を高める手段として広く使われているのがtypedefです。構造体を定義するたびにstruct SensorDataと記述する手間を省き、独自の型名として定義できるため、入門書でも多用されます。
/ typedefによる型定義 / typedef struct { int x; int y; } Point; Point p1 = {10, 20}; / "struct" を付けずに宣言可能 / 一見すると極めて合理的ですが、大規模開発の現場ではこのtypedefを巡って深刻な設計摩擦が生じています。特に「構造体ポインタまでtypedefで隠蔽する手法」は、多くの開発現場で厳禁とされています。
/ 現場で嫌われるアンチパターン:ポインタの隠蔽 / typedef struct SensorData SensorPtr; SensorPtr p = &s1; /* 一見ポインタに見えないため、読み手がメモリ操作の意識を失う / Linuxカーネルの開発ガイドラインをはじめとする厳格なプロジェクトでは、「それがポインタであるか実体であるかを明示すること」がコードの安全性を担保する鉄則とされています。型名を見ただけでメモリの実体がスタックにあるのか、ヒープにあるのか、参照渡しなのかが判別できなくなるからです。
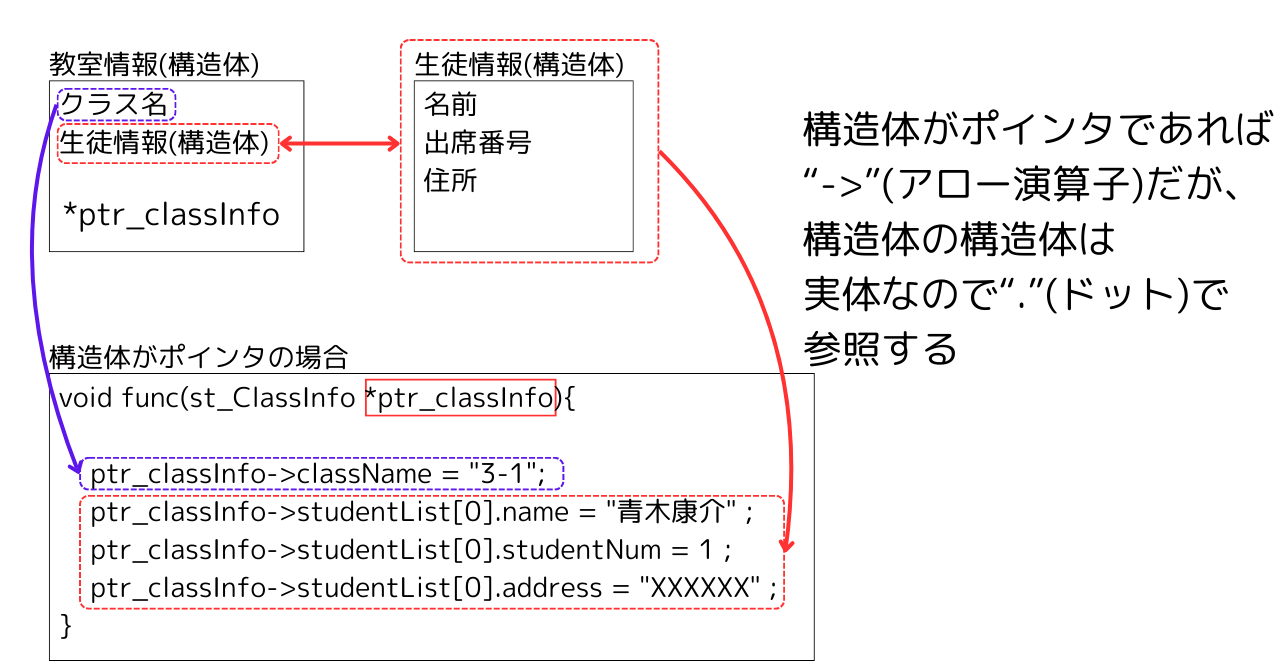
そして、ポインタを経由してメンバにアクセスする際に必須となるのがアロー演算子(->)です。初学者が最も混乱しやすいドット演算子との違いは、以下の等価式を見れば一目瞭然です。
struct SensorData *ptr = &s1; / 以下の2行は完全に同じ処理を実行している / (ptr).value = 25.0; /* ポインタをデリファレンス(実体化)してからドット演算子 / ptr->value = 25.0; / アロー演算子による簡潔な間接アクセス / 「実体ならドット、ポインタならアロー」。この規則を文法として丸暗記するのではなく、「ポインタの指す先を展開してからメンバを探す手間を、アロー演算子1つで肩代わりしている」という力学を意識することが極めて重要です。
図解で暴くメモリ配置の真相|sizeofの数値が合わないパディングとアライメント
構造体を学び始めたプログラマが必ず遭遇する最大のミステリーが、「メンバのバイト数を合計してもsizeof演算子の結果と一致しない」という現象です。この違和感を放置することが、後々のバグやシステムクラッシュを引き起こす温床となります。
具体的なコードで検証してみましょう。
struct BadLayout { char a; / 1バイト / int b; / 4バイト / char c; / 1バイト / }; printf("合計想定: %zu バイト\n", 1 + 4 + 1); / 6バイト / printf("実際のサイズ: %zu バイト\n", sizeof(struct BadLayout)); / 環境により12バイト! / 1 + 4 + 1 = 6バイトになるはずが、64bitアーキテクチャの一般的なコンパイラでは12バイトと出力されます。倍近いメモリが消費されている計算です。なぜこのような差が生まれるのでしょうか。
原因は、CPUがメモリにアクセスする際の効率を最適化する「アライメント(整列配置)」と、隙間を埋める「パディング(詰め物)」にあります。現代の32bitや64bit CPUは、1バイトずつメモリを読むのではなく、4バイトまたは8バイト単位の「バス幅」でまとめてデータを読み書きします。4バイトの整数データが中途半端なアドレス(奇数アドレスなど)に配置されていると、CPUはメモリへ2回アクセスしなければならず、性能が著しく低下します。
【BadLayoutのメモリ配置(12バイト消費)】 アドレス: 0 1 2 3 4 5 6 7 8 9 10 11 データ: [a] [Pad][Pad][Pad] [ b (4byte) ] [c] [Pad][Pad][Pad] ↑1byte ↑4の倍数アドレスへ配置 ↑1byte ↑構造体全体の倍数合わせ
コンパイラは自動的に空き領域(パディング)を挿入し、各メンバを適切な境界アドレスに整列させます。さらに、構造体配列を作成した際に後続要素のアライメントが崩れないよう、構造体全体のサイズも最大メンバの倍数(この場合は4の倍数)に繰り上げられます。
この無駄を排除するためには、「大きいデータ型のメンバから順に宣言する」ことが鉄則です。
struct GoodLayout { int b; / 4バイト / char a; / 1バイト / char c; / 1バイト / / 末尾に2バイトのパディングが入る / }; printf("最適化後のサイズ: %zu バイト\n", sizeof(struct GoodLayout)); / 8バイト! / 【GoodLayoutのメモリ配置(8バイト消費)】 アドレス: 0 1 2 3 4 5 6 7 データ: [ b (4byte) ] [a] [c] [Pad][Pad] ↑1B ↑1B ↑計4の倍数に調整
メンバの宣言順を並び替えただけで、メモリフットプリントを33%以上削減できました。数百万個の構造体インスタンスを扱う通信処理や組み込み環境において、この知識の有無はハードウェアコストやバッテリ消費量に直結する死活問題となります。

【徹底比較】構造体・共用体・配列の違いとパフォーマンスの実態
C言語における複合データ構造には、構造体のほかに「共用体(union)」や「配列」が存在します。それぞれの用途とメモリ上の挙動、さらに関数への受け渡しに伴う負荷を体系的に整理したのが以下の比較表です。
| 項目 | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| 構造体 (struct) | 全メンバが独立したメモリ領域を保持。サイズ=メンバ合計+パディング。 | アライメント依存で数B〜数KB。用途ごとに最適化必須。 | 状態保持や複雑なデータ表現の標準。宣言順序の意識が不可欠。 |
| 共用体 (union) | 全メンバが同一メモリ領域を共有。サイズ=最大メンバのサイズ(+調整)。 | 複数メンバのうち「同時に1つ」しか値を保持できない。 | パケット解析や省メモリ設計で威力を発揮。型安全性の管理は自己責任。 |
| 配列 (Array) | 同一データ型が隙間なく連続。サイズ=要素サイズ × 要素数。 | パディングは一切発生しない。インデックスによるO(1)アクセス。 | 同質データの反復に特化。異種データを束ねる構造体配列の基礎となる。 |
| 関数引数:値渡し | 構造体全データがスタック上に丸ごとコピーされる。 | 構造体サイズが16バイト超で呼出コストが顕著に増大。 | 関数内での意図せぬ変更を防げるが、実務の大規模データでは非推奨。 |
| 関数引数:ポインタ渡し | アドレス(4または8バイト)のみを転送。オーバーヘッド極小。 | CPUレジスタ経由で高速受渡し(0〜1クロックサイクル)。 | const Structを使用し、書き換え防止と高速化を両立するのが実務の定石。 |
関数に構造体を渡す際の実装パターンとして、現場で最も推奨されるのが「const参照渡し」です。
/* 実務で標準とされる関数プロトタイプ / void ProcessData(const struct SensorData *data) { / data->value = 0.0; コンパイルエラーとなり誤変更を防止 / printf("ID: %d, Val: %.2f\n", data->id, data->value); } 値渡しのように構造体全体をスタックに複製するコストをゼロにしつつ、ポインタ渡しの最大の弱点である「呼び出し先での意図しない値の破壊」をコンパイラレベルで完全に遮断できます。
【実態検証】組み込み現場とメガベンチャー開発者が語るリアルの声
ITmediaや各種開発コミュニティ、エンジニア座談会などで報告される「現場で起きた構造体の事故」を検証すると、理論通りの教科書的知識だけでは太刀打ちできない過酷な現実が浮かび上がってきます。
車載マイコンや通信モジュール開発に携わるシニアファームウェアエンジニアは、次のような生々しい証言を寄せています。
「新人がネットワークパケットの受信バッファ(char[])を、そのまま通信ヘッダの構造体ポインタにキャストして参照しようとし、ハードウェア例外(Bus Error)でマイコンが停止する事故がありました。理由は単純で、受信したバッファの先頭アドレスが4バイト境界に揃っていなかったためです。コンパイラがアライメントを前提とした機械語を吐いていたため、CPUが未整列アクセスを検知してトラップを発生させました。構造体と物理アドレスの結合度を理解していないと、こういった致命的な不具合を招きます」
また、Webサービスの大規模バックエンドやインフラ領域を支えるエンジニアからも、メモリ効率化に伴う罠についての証言があります。
「パディングを削って通信データ量を極限まで減らすため、GCCのattribute((packed))やMSVCの#pragma pack(1)を多用したコードが引き継がれました。確かにメモリ消費量は減ったものの、アライメントが強制解除されたことで、毎秒数万回アクセスされるループ処理でCPUの実行サイクル数が30%以上悪化し、結果としてサーバー台数を増やさざるを得ない本末転倒な事態に陥った経験があります」
現場の声が示すのは、単に「パディングをなくせば良い」「ポインタを使えば速くなる」という短絡的な思考の危うさです。ハードウェアとコンパイラが協調して動作するメカニズムへの深い洞察があってこそ、構造体の真の威力が発揮されます。
一般に知られていない盲点とネットの誤解
ネット上の技術ブログや質問サイトでは、初級者を惑わす誤解や不正確な通説が散見されます。代表的な3つの誤解を正しく解体していきましょう。
誤解1:「構造体を使えばC++やJavaのクラスと完全に同じことができる」
構造体の中に関数ポインタを保持させることで、オブジェクト指向の「メソッド」に似た挙動を模倣することは可能です。実際、Linuxカーネルの仮想ファイルシステム(VFS)などでこの手法が採用されています。
しかし、C言語の構造体自体にはカプセル化(アクセス制限)、継承、多態性を直接サポートする言語機能はありません。アクセス制御を強制できないため、無理に擬似オブジェクト指向を組もうとすると、コードが過度に複雑化し可読性を著しく損ないます。C言語の構造体は「データの透明な配置」に専念させるのが堅牢な設計への近道です。
誤解2:「小さな構造体であっても、引数はすべてポインタで渡すべき」
「コピー処理は悪である」という過度の思い込みから、メンバがint1個やchar2個程度の極小構造体までポインタ渡しにする例が見られます。しかし、現代のABI(アプリケーションバイナリインターフェース)では、64bit(8バイト)以下の小さな構造体はスタックではなくCPUの汎用レジスタに直接格納されて渡されるケースがほとんどです。
極小サイズの構造体をあえてポインタ渡しにすると、メモリ参照のオーバーヘッド(間接参照コスト)が余計に発生し、かえって処理速度が低下することがあります。
誤解3:「共用体を使えばどんなデータ型も安全に型変換できる」
共用体を利用して浮動小数点数のビットパターンを整数型として読み出すようなコード(いわゆるType Punning)は古くから使われてきました。しかし、C規格(C99/C11以降)における厳格な別名規則(Strict Aliasing Rule)に違反すると、コンパイラの最適化によってコードが削除されたり、予期せぬ動作を引き起こす未定義動作(Undefined Behavior)につながる危険があります。
【プロの結論】構造体を使いこなせる人・挫折する人の境界線と設計思想
システム開発や組み込みの現場において、構造体を自在に操るエンジニアと挫折するエンジニアの間には、思考様式における決定的な「心理的境界線」が存在します。
挫折するプログラマは、コードを「文法記号の羅列」として捉え、ドットやアローの使い分けをパズルのように暗記しようとします。そのため、ポインタの配列や多重間接参照が現れた瞬間にワーキングメモリが飽和し、コードが追えなくなってしまいます。
一方、構造体を完全に掌握できるプログラマの脳内には、常に「メモリの矩形図(グリッドマップ)」が描かれています。
- 宣言された変数がスタック上のどのアドレスから何バイト占有しているか
- パディングによってどこに空白のバイトが挟まっているか
- ポインタという矢印が、どのメモリブロックの先頭を指し示しているか
この「物理的な配置図」を紙や頭の中で視覚化できるかどうかが、プロフェッショナルへの決定的な分水嶺となります。文法に振り回されるのをやめ、コードの背後にあるメモリ空間を観察する視点を持つこと。それこそが、C言語の構造体を攻略する唯一絶対の近道です。
【構造 体 c 言語】に関するよくある質問(FAQ)
Q1:構造体を関数の戻り値(return)として返すのは避けるべきですか?
A1:サイズが16バイトを超えるような大きな構造体の場合は避けるのが無難です。スタック領域でのメモリコピーが発生し、パフォーマンスが低下するためです。戻り値として大きなデータを返したい場合は、呼び出し元で領域を確保した構造体へのポインタを関数の引数(出力引数)として渡し、関数側でその領域に値を書き込む設計が実務での標準です。
Q2:アロー演算子(->)とドット演算子(.)の使い分けで迷ったときの確実な見分け方は?
A2:対象の変数の型宣言を確認してください。型にアスタリスク()が付いているポインタ変数であれば「アロー演算子(->)」、アスタリスクが付いていない実体変数であれば「ドット演算子(.)」を使用します。迷ったときは「ポインタは矢印(アロー)を飛ばして指し示す」とイメージすると直感的に定着します。
Q3:構造体の中に別の構造体を含める(入れ子にする)ことはできますか?
A3:可能です。構造体メンバとして別の構造体の実体を直接埋め込むことも、別の構造体へのポインタを持たせることもできます。実体を埋め込む場合は包含関係(has-a関係)となり、外側の構造体サイズに内側の構造体サイズ(およびアライメントパディング)が加算されます。
Q4:構造体の内容を丸ごとコピーしたい場合、memcpyを使う必要がありますか?
A4:同じ型の構造体変数同士であれば、代入演算子(=)を使って代入するだけで全メンバが一括コピーされます。コンパイラが適切なメモリコピーコードを生成するため、通常はmemcpyを明示的に呼び出す必要はありません。ただし、メンバにポインタが含まれている場合は「浅いコピー(アドレスのみのコピー)」となるため、指し示す実体の複製が必要な場合は注意が必要です。
まとめ:2026年のシステム開発に求められる構造体設計の真価
高度に抽象化されたプログラミング言語が席巻する時代において、C言語の構造体を深く学ぶ意義は薄れるどころか、むしろ希少価値を高めています。AIアクセラレータ、次世代車載OS、ロボティクスといった最先端領域の現場では、極小のレイテンシと厳格なメモリ制約をクリアできる技術者が常に渇望されているからです。
構造体は、人間が理解しやすい論理モデルと、コンピュータが処理しやすい物理メモリの架け橋となる存在です。メンバのアライメントを意識した配置設計、ポインタとアロー演算子による正確な間接参照、そしてconstを活用した安全設計。これらをマスターしたとき、C言語は難解な言語から、ハードウェアを意のままに操る最強のツールへと姿を変えるはずです。 (出典: 構造 体 c 言語(Yahoo!ニュース))
情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。