外れ値の求め方と判定基準!IQRや3シグマ法・Excel実践図解
データ分析の現場で多くの担当者を悩ませるのが、全体から極端に乖離した数値の存在です。売上分析やマーケティングリサーチ、工場の品質管理に至るまで、たったひとつの極端な数値が平均値を大きく歪め、意思決定を根底から狂わせてしまうリスクは日常的に潜んでいます。しかし、直感だけに頼って「何となく邪魔だから消す」という安易な処理を行えば、本来捉えるべきビジネスの急成長サインや重大な欠陥を見落とす危険性すらあります。
データの客観性と信頼性を担保するためには、統計学的な裏付けに基づいた外れ値判定基準を正しく運用しなければなりません。四分位範囲(IQR)を活用した堅牢な計算アプローチから、実務で多用される3シグマ法、統計的仮説検定であるスミルノフ・グラブス検定、さらにはExcel関数を用いた即戦力の自動化手法まで、実務現場のリアルな課題とともに体系的に解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:外れ値検出の王道は「四分位範囲(IQR)の1.5倍ルール」と「3シグマ法」であり、データの分布特性(正規分布か非対称か)に応じた使い分けが不可欠。
- 要点2:Excelの「QUARTILE.INC」や「STANDARDIZE」などの外れ値エクセル関数を駆使すれば、数千件のレコードでも瞬時に自動フラグ付けと可視化が可能。
- 要点3:検出した数値を機械的に削除するのは悪手であり、測定ミスによる「異常値」と、新需要や不正兆候を示す「有意な外れ値」を切り分ける選別眼こそが分析の成否を分ける。
【データの落とし穴】外れ値と異常値の違いとは?現場を惑わす正体
データ分析において、日常的に混同されがちな概念が「外れ値(Outlier)」と「異常値(Anomaly / Contaminant)」です。分析の現場や実務コミュニティでもこの2つを同一視する声が散見されますが、統計学的なアプローチおよび実務上の処置は明確に分かれます。
統計教育メディア「スタビジ」の解説にも見られる通り、例えば成人男性の体重測定データの中に「-999kg」という数値が混入していた場合、これは物理的にあり得ない数値であり、システムのエラーコードやキーパンチの入力ミス、センサーの一時的不具合によって生じた明確な「異常値」に分類されます。発生原因が誤謬(エラー)にあると立証できる異常値は、データクレンジングの段階で速やかに修正または削除の対象となります。
一方で、平均体重が68kgの集団の中に「145kg」のアスリートが1名含まれていた場合、これは物理的に実在し得る極端な測定値であり、統計学上の「外れ値」です。外れ値とは、「他の大半の観測値から大きく乖離しているものの、測定自体は正しく行われた正当なデータ」を指します。この2つの境界線を曖昧にしたままデータ分析異常値処理を進めてしまうと、本来分析から排除すべきノイズを残してしまったり、逆に貴重な顧客セグメントの兆候を消し去ってしまったりする事態を招きます。
【代表的な計算手順】四分位範囲(IQR)と3シグマ法による外れ値検出法
直感ではなく客観的な数値基準でデータをスクリーニングするための、統計学外れ値検出法として広く採用されている2大手法の計算手順を解説します。
1. 四分位範囲(IQR)を用いた判定基準と箱ひげ図外れ値計算
データの外れ値判定において、最も汎用性が高く外れ値の影響を受けにくい頑健(ロバスト)な手法が、四分位数IQR求め方をベースにした基準です。データを昇順(小さい順)に並べ、全体を4等分する境界値を用います。
具体的なステップは以下の通りです。
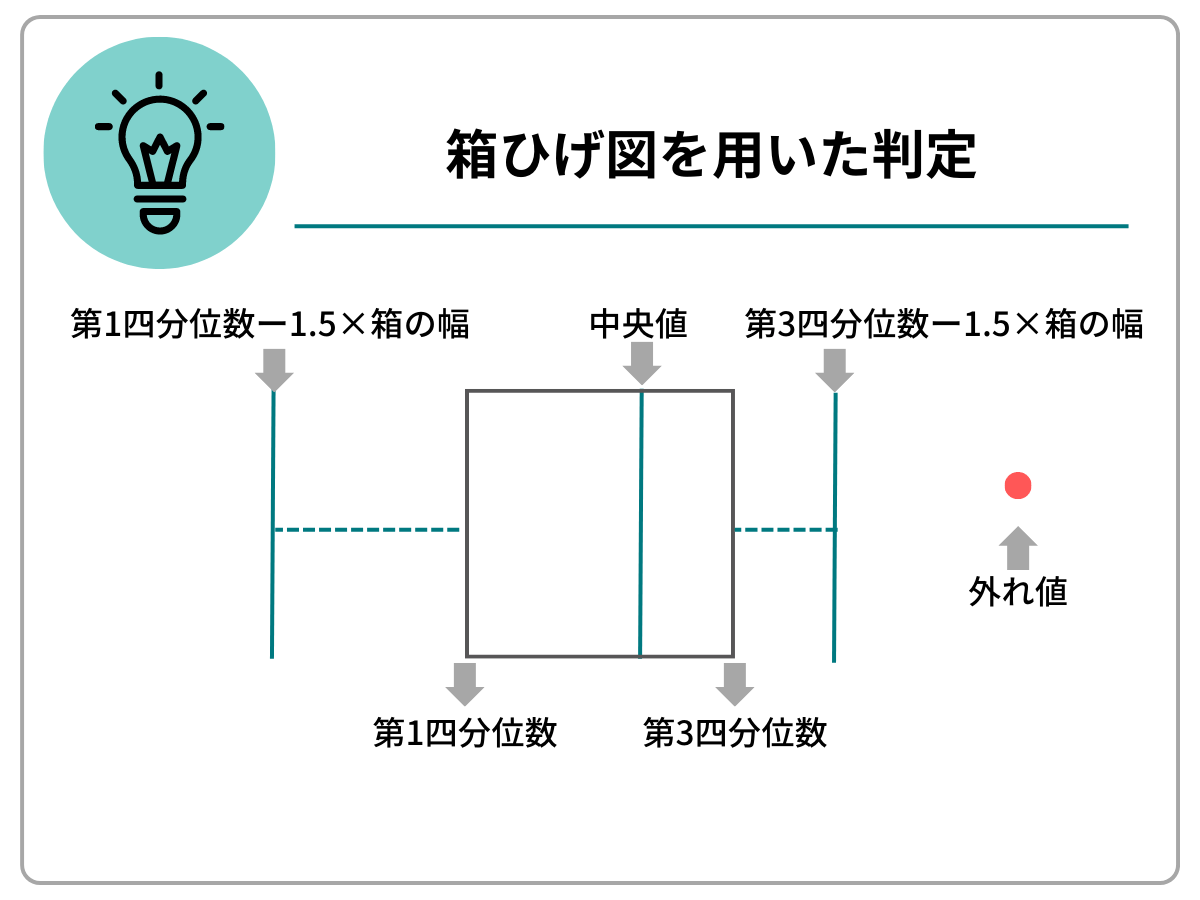
- 第1四分位数(Q1):データの下位25%に位置する値
- 第3四分位数(Q3):データの上位25%(下位75%)に位置する値
- 四分位範囲(IQR):中央に位置する50%のデータ幅。計算式は IQR = Q3 - Q1
- 外れ値の境界線(フェンス):
- 上限境界値 = Q3 + (1.5 × IQR)
- 下限境界値 = Q1 - (1.5 × IQR)
この上下の境界線の外側に飛び出したデータポイントを外れ値四分位範囲の基準に合致するものとして判定します。このロジックは統計グラフの基本である「箱ひげ図」のヒゲの終端と完全に一致しており、ExcelやBIツールで箱ひげ図を描画した際に独立した点でプロットされるものがまさにこの計算に基づいています。
2. 外れ値3シグマ法(3σ法)と平均・標準偏差の落とし穴
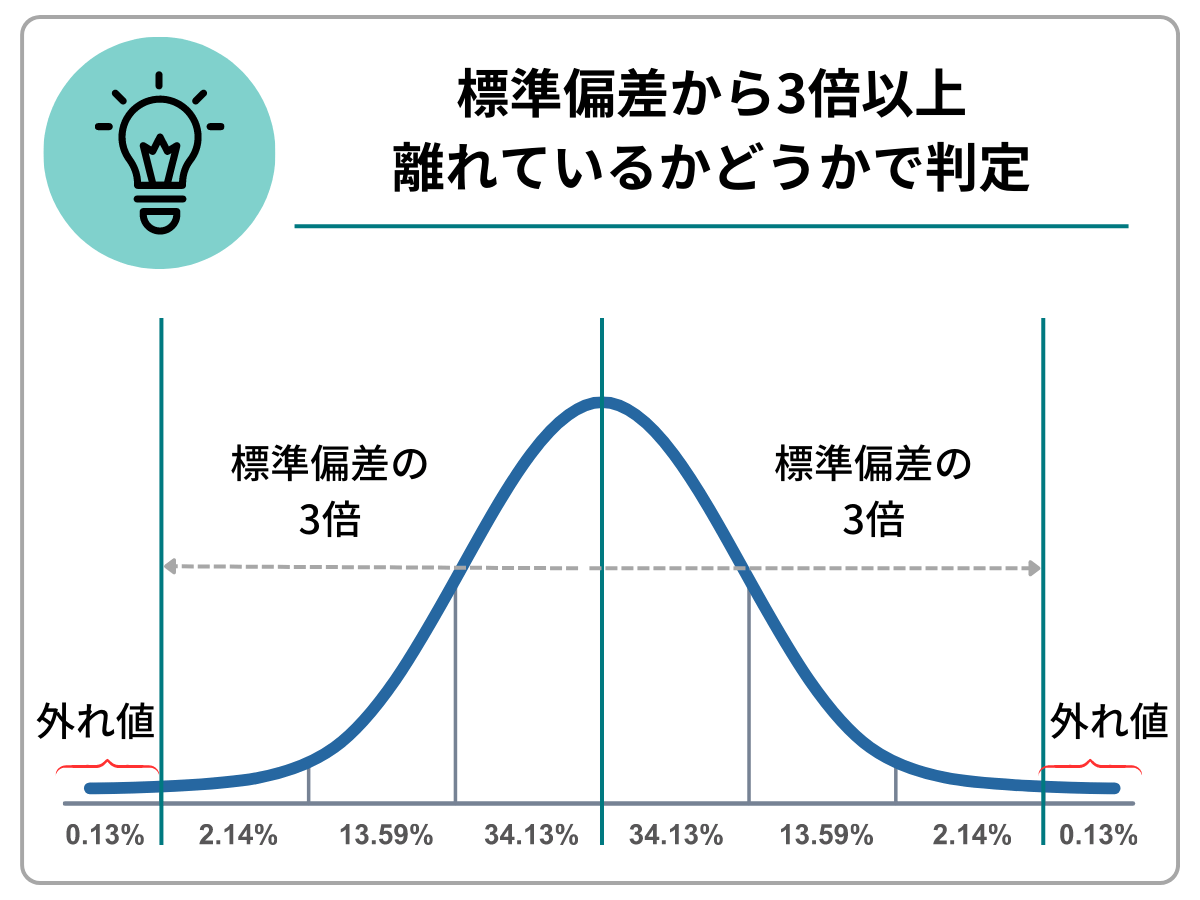
製造業の品質管理や工程能力指数(Cp/Cpk)の算出などで伝統的に使われるのが、正規分布を前提とした「外れ値3シグマ法」です。平均値(μ)から標準偏差(σ)の3倍以上離れた区間を異常・外れと見なします。
正規分布に従うデータにおいて、平均値 ± 1σの範囲には全体の約68.27%、± 2σには約95.45%、そして± 3σの範囲には全体の99.73%が収まります。すなわち、3σの外側に観測値が現れる確率はわずか0.27%(およそ370回に1回)に過ぎないため、これを外れ値判定基準とする理屈です。
ただし、GMOリサーチ&AIの技術リポートでも警鐘が鳴らされているように、「標準偏差そのものが極端な外れ値に引きずられて肥大化する」という構造的弱点には十分な警戒が必要です。極端に巨大な値が存在すると平均値と標準偏差が一気に跳ね上がり、本来なら検出されるべき他の外れ値が「± 3σ」の内側に埋もれてしまうマスキング効果が発生します。3シグマ法を適用する際は、ヒストグラムでデータが釣鐘型の正規分布を描いているか事前に確認するステップが必須です。
3. 小規模データ向けの検定手法「スミルノフグラブス検定」
サンプルサイズ(データ件数)が数十件程度と少なく、なおかつ1つの極端な値が外れ値かどうかを厳密に統計的仮説検定したい場合に有効なのがスミルノフグラブス検定です。
Wikipediaの統計解説にもある通り、疑わしい標本値と平均値の差を不偏標準偏差で割った検定統計量(T値)を算出し、有意水準(一般に1%または5%)における棄却限界値と比較します。この検定は1回につき1つの外れ値しか検定できないため、外れ値を1件除外したら再度平均と標準偏差を再計算して繰り返し検定を行う必要があります。
【徹底比較】どの手法を使うべき?外れ値判定基準のメリット・デメリット一覧
データ分析の目的やデータの分布特性によって、選択すべきアプローチは根本から異なります。現場で迷わないための判断材料を比較表として整理しました。
| 検出手法 | 適用条件・計算ロジック | 長所(メリット) | 短所・注意すべき盲点 |
|---|---|---|---|
| 四分位範囲(IQR法) | Q3 + 1.5×IQR 超、または Q1 - 1.5×IQR 未満 | 分布の歪み(非対称)に強く、極端な値があっても境界が安定。 | データ数が極端に少ない(N<10程度)場合は分位点の精度が落ちる。 |
| 3シグマ法(3σ法) | 平均値 ± 3 × 標準偏差 | 計算が直感的で、製造業の管理図などで国際標準化されている。 | 正規分布が前提。外れ値自体のせいで平均や標準偏差が歪む。 |
| スミルノフ・グラブス検定 | 検定統計量 T = |x - μ| / s 有意水準5%等の臨界値と比較 | サンプル数が少なくても厳密な確率論的判断が可能。 | 1件ずつしか検証できず、大量データの一括スクリーニングには不向き。 |
| 機械学習アルゴリズム (Isolation Forest等) | 多次元データの隔離容易度を 決定木ベースで数値化 | 複数変数が絡み合う多変量外れ値を高精度に検出可能。 | ブラックボックス化しやすく、Excel単体での即時算出は困難。 |

【実務直結】Excel(エクセル)関数だけで完結する外れ値の自動判定テクニック
専門の統計ソフトやPythonを使わずとも、業務で最も身近なExcelを活用すれば、数千〜数万行のレコードから一瞬で外れ値を洗い出すことが可能です。ここでは現場で重宝するIQR法を用いた外れ値エクセル関数の実装手順を解説します。
データがA列(A2:A101)に入力されていると仮定した場合、空いているセルに以下の数式を配置して判定基準を定義します。
- 第1四分位数(Q1)の算出:
=QUARTILE.INC(A2:A101, 1) - 第3四分位数(Q3)の算出:
=QUARTILE.INC(A2:A101, 3) - 四分位範囲(IQR)の算出:
=Q3のセル - Q1のセル - 下限値の算出:
=Q1のセル - 1.5 * IQRのセル - 上限値の算出:
=Q3のセル + 1.5 * IQRのセル
※四分位数を求める関数にはQUARTILE.INC(0%と100%を含む)とQUARTILE.EXC(0%と100%を除外する)が存在しますが、実務データの外れ値算出では業界標準としてQUARTILE.INCを用いるのが一般的です。
境界値が算出できたら、B列に判定フラグを立てる論理式を記述します。B2セルに以下の数式を入力し、下方向へオートフィルでコピーします。
=IF(OR(A2 < 下限値セル, A2 > 上限値セル), "外れ値", "正常")
さらに、視覚的に異常値を即時察知したい場合は、A列全体を選択して「ホーム」タブの「条件付き書式」→「新しいルール」を開き、=OR(A2 < 下限値セル, A2 > 上限値セル) と数式を入力して背景色を薄い赤色に設定します。このわずか数分のセットアップだけで、目視確認に頼ったチェック作業を完全に自動化できます。専用の外れ値計算ツールを外部から導入しなくても、社内のスプレッドシート上で堅牢なチェックパイプラインが構築可能です。
【実態検証】データ分析現場のリアルな声と「即座に削除」が招く悲劇
実務の現場において、多くの初学者が陥る典型的な過ちが「外れ値フラグが立った数値を片っ端から行ごと削除する」という行為です。知恵袋やSNSなどのエンジニアコミュニティでも、「売上の中央値を出そうとして突出したトップ顧客データを消したら、売上の4割を占める大口取引の傾向を見失った」「回帰分析の決定係数(R2)を上げたいがために外れ値を間引いたら、上司からデータ改ざんだと厳しく指摘された」といった苦い告白が後を絶ちません。
人間には、自らが信じたい仮説に都合の悪い数値を「これは例外的な異常値だから分析から省いても構わないだろう」と無意識に正当化してしまう強力な心理バイアス(確証バイアス)が働きます。例えば、あるWebサービスの利用時間データを集計した際、大半のユーザーが1日15分程度のところ、1日8時間以上ログインし続ける極端なアカウントが複数観測されたとします。
これを単なる「外れ値」として思考停止でパージしてしまうと、そのユーザーたちが「熱狂的なヘビーユーザー」なのか、あるいは「競合によるスクレイピングボットの不正アクセス」なのかという、ビジネス上極めて重要な示唆を検証する機会が永遠に失われます。極端な値こそが、既存の想定を破壊して新たなビジネスチャンスやセキュリティリスクを告げる炭鉱のカナリアであるケースは決して少なくありません。
【一般に知られていない盲点】安易な外れ値除外は厳禁!残すべきケースと除外理由
外れ値に直面したとき、データサイエンティストや経験豊富なアナリストが遵守している外れ値の扱い方と注意点には、明確な判断軸があります。正当な外れ値除外理由が成立するか否かを検証するプロセスこそが、分析の品質を決定づけます。
外れ値を除外してよい明確な基準
データを全体の母集団から取り除く、あるいは修正することが正当化されるのは、以下のような客観的根拠が存在する場合に限られます。
- プロセスの誤りが明白な場合:アンケートで年齢欄に「999」と入力されている、マイナスの金額が計上されているなど、明らかなタイポやシステム欠損値コード。
- 母集団の定義から外れている場合:BtoC(一般消費者向け)の購買データの中に、仕入れ目的の法人バイヤー取引が1件だけ混在していた場合など、調査対象の定義そのものと矛盾している場合。
- 機材・通信の物理的エラー:IoTセンサーの電源断や通信瞬断によって生じたスパイクノイズであることがログから立証できる場合。
外れ値を除外せず活かすべき代替アプローチ
一方で、データが正しく計測された実世界の現象であるならば、安易に削除するのではなく分析手法側をアジャストさせるのがプロフェッショナルの鉄則です。
- 代表値を「平均値」から「中央値」へシフトする:年収や不動産価格のように、一部の超富裕層が平均を吊り上げるデータでは、外れ値を除去するのではなく中央値(メディアン)を主軸に置いて議論を構築します。
- ウィンザライズ(Winsorization:縮約法):外れ値を削除する代わりに、例えば上位95%点(または下限値・上限値)の値へと数値を置き換えることで、データの行数(サンプルサイズ)を維持したまま影響度を緩和します。
- 外れ値群を独立したセグメントとして別個に分析する:全体分析からは一時的に分離しつつも、「なぜこの特異な行動が発生したのか?」を単独でクラスター分析や定性調査に回し、深掘りします。
【プロの結論】除外すべきデータ・保持すべきデータの意思決定マトリクス
組織における意思決定の場において、アナリストは「向いている判断」と「避けるべき独断」の境界線を冷徹に見極めなければなりません。
【外れ値の即時除外が向いているケース】
目的が「一般的な標準ユーザーの典型的体験」のモデル化であり、なおかつ除外理由(測定ミスや定義外データ)を第三者に論理的に説明できるエビデンスが揃っている状況。この場合、除外したレコード数と除外ルールをレポートに明記した上で処理を進めるのが誠実な作法です。
【外れ値の安易な除外を絶対に避けるべきケース】
リスクマネジメント(信用取引の焦げ付き予測、金融不正検知、工場の安全基準テストなど)を目的とした分析では、外れ値そのものが分析の主役となります。ここで「外れ値を除外してモデルの精度が上がった」と喜ぶ行為は、重大事故の予兆を自ら塗りつぶす自殺行為に他なりません。
【外れ値の求め方】に関するよくある質問(FAQ)
Q1:外れ値と異常値の明確な違いは何ですか?
A1:外れ値は「統計的に大半のデータから大きく離れているが、現実に発生した正当なデータ」を含みます。一方、異常値は「入力ミスや機器の故障など、原因が誤謬(エラー)にあると分かっている現実にはあり得ない数値」を指します。異常値は修正・削除の対象ですが、外れ値は安易に削除せず慎重な扱いが求められます。
Q2:四分位範囲(IQR)の計算で「1.5倍」を掛けるのはなぜですか?
A2:統計学者ジョン・テューキーが箱ひげ図を考案した際、正規分布において平均±約2.7シグマ(全体の約99.3%が含まれる範囲)に相当する経験則として設定された係数です。より厳格に極端な値だけを特定したい場合は、1.5の代わりに「3倍」を掛けて「極端な外れ値」として判定する手法も実務で広く使われています。
Q3:サンプル数が少ない場合でも3シグマ法を使って問題ありませんか?
A3:おすすめできません。サンプルサイズが数十件未満の場合、1つの外れ値が平均値と標準偏差を過度に引き上げてしまい、3シグマの網から漏れてしまうマスキング現象が起きます。データ数が少ない場合は、スミルノフ・グラブス検定を用いるか、あるいは四分位範囲(IQR法)を基準にするのが安全です。
Q4:Excel以外で手軽に外れ値判定を行えるツールはありますか?
A4:TableauやPower BIといった主要なBIツールには箱ひげ図機能が標準搭載されており、ドラッグ&ドロップで外れ値を即座に可視化できます。また、Pythonの「pandas」や「seaborn」、統計解析ツール「R」を用いれば、スクリプト数行でIQR判定から高度な多変量外れ値検出(Isolation ForestやLOFなど)まで柔軟に自動処理が可能です。
まとめ:統計学的根拠に基づきデータの真価を引き出す道筋
データ分析における外れ値の処理は、単なる数値のクレンジング作業にとどまらず、分析者の倫理観とビジネス理解の深さが試される極めて戦略的なプロセスです。直感に頼った恣意的なデータ除外は分析結果を歪め、組織の意思決定を誤った方向へ導くリスクを常に孕んでいます。
まずはデータの分布を確認し、正規分布であれば3シグマ法、歪みがあるデータ群には四分位範囲(IQR法)といった適切な計算手順を選択すること。そして検出された数値に対して「なぜこの数値が生じたのか」という背景と文脈を突き詰めること。この規律あるステップを徹底することこそが、データの持つ真の価値を引き出し、揺るぎない説得力を持つインサイトへと昇華させる唯一の鍵となります。 (出典: 外れ 値 求め 方(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。